Objetivos de aprendizagem
- O1. Explicar o perceptron multicamadas como composição de transformações e não-linearidades.
- O2. Derivar backpropagation como aplicação da regra da cadeia.
- O3. Implementar uma rede densa em NumPy, do forward ao update.
- O4. Diagnosticar os modos de falha do treino: gradiente que some, que explode, e inicialização ruim.
- O5. Executar um MLP num conjunto de dados real e diagnosticar o efeito da escala dos atributos sobre o treino.
O problema: sabia-se qual era a rede, e não havia como treiná-la
No capítulo III.1 você travou em 3 de 4. O XOR não sai com um neurônio só, e o motivo é geometria: uma reta não separa cantos opostos de um quadrado.
Este capítulo resolve isso — e vale dizer com prazer, porque a solução é curta: duas retas. Uma camada intermediária traça duas fronteiras, e a camada de saída combina as duas. O XOR fecha em 4 de 4.
Só que essa não era a parte difícil. Depois de 1969 já se sabia que uma camada intermediária resolvia o XOR. Qualquer um conseguia escrever à mão os pesos que fazem aquilo funcionar — você vai escrever mais adiante neste capítulo. O que não existia era um jeito de descobrir esses pesos a partir de dados, quando eles são milhares e ninguém sabe o que cada unidade escondida deveria significar.
A regra do perceptron não servia: ela corrige pesos comparando a saída com o rótulo, e a camada escondida não tem rótulo. Ninguém sabe o que a terceira unidade da camada do meio deveria ter respondido. Esse é o aperto, e ele durou quase vinte anos.
Foi isso que 1986 entregou: não a arquitetura, que já se conhecia, mas o procedimento para treiná-la.
De onde isto veio
O aperto. A arquitetura estava disponível e inerte. Havia camadas escondidas, havia demonstração de que elas resolviam o que uma camada não resolve, e não havia sinal de erro para elas. A pergunta não era "que rede usar?", era "como atribuir culpa a um peso que fica no meio do caminho?".
O que se fazia antes. Duas saídas, ambas ruins. Ficar na camada única com a regra do perceptron — barato, convergente, e limitado ao que é linearmente separável. Ou pôr os pesos escondidos à mão, projetando cada unidade intermediária como se fosse uma função lógica. Funciona em brinquedos como o XOR; não funciona em nada com mais de uma dúzia de unidades.
A virada, e ela vem em ordem inversa à intuição. Primeiro veio o procedimento: em 1986, Rumelhart, Hinton e Williams popularizam o backpropagation e mostram que as camadas escondidas aprendem representações úteis sozinhas. Só depois veio a licença teórica. Cybenko, em Approximation by superpositions of a sigmoidal function (Math. Control Signals Systems, 1989), e Hornik, em Approximation capabilities of multilayer feedforward networks (Neural Networks 4:251–257, 1991), provam que uma única camada escondida aproxima qualquer função contínua — desde que haja unidades suficientes.
Repare na ordem. A engenharia funcionou por três anos antes de a matemática dizer que ela podia funcionar. Isso é mais comum do que os livros contam, e é um bom antídoto contra a ideia de que teoria precede prática.
A ideia reaproveitável — e é a tese deste capítulo: existência não é treinabilidade. O teorema diz que a rede certa está no espaço de hipóteses. Não diz de quantas unidades ela precisa. Não diz como achá-la. E não diz se o gradiente descendente chega até ela partindo de onde você inicializou. É um resultado não construtivo: garante que o objeto existe sem dar receita para construí-lo.
Guarde isso, porque a confusão é cara e frequente. "A rede pode representar qualquer função" é uma afirmação sobre o conjunto de funções representáveis. "A rede vai aprender essa função" é uma afirmação sobre o procedimento de busca, sobre os dados e sobre a inicialização. Os vinte anos de dificuldade que o capítulo III.3 narra, com gradientes que somem, gradientes que explodem e redes profundas que não treinavam, são o preço dessa distinção.
O nome. "Teorema da aproximação universal" é rótulo posterior, e convém ser exato sobre em que sentido. A palavra "universal" está num título da época: "Multilayer feedforward networks are universal approximators", de Hornik, Stinchcombe e White (Neural Networks 2:359–366, 1989). O que veio depois foi a promoção a teorema com nome próprio. Os artigos enunciam o resultado com hipóteses explícitas, e quase ninguém as recita junto com o nome.
E há um detalhe atribuído a Hornik que o rótulo popular apaga: o poder de aproximação não viria da função de ativação escolhida, e sim da estrutura em camadas. Trocar sigmoide por outra não-linearidade razoável não mudaria o que a rede pode representar. Mudaria o quanto ela treina bem, que é assunto do livro inteiro.
Procedência das afirmações desta seção:
| Selo | Afirmação |
|---|---|
| ✓ᵐ | Cybenko, Approximation by superpositions of a sigmoidal function, Math. Control Signals Systems (1989); Hornik, Approximation capabilities of multilayer feedforward networks, Neural Networks 4:251–257 (1991). Os artigos não foram lidos por inteiro |
| ✓ᵐ | Hornik, Stinchcombe & White, "Multilayer feedforward networks are universal approximators", Neural Networks 2:359–366, 1989, 10.1016/0893-6080(89)90020-8 — ficha conferida |
| ❌ | Correção de 2026-08-13. Esta linha dizia que a expressão "aproximação universal" não consta do título de nenhum dos artigos. Era verdade sobre os dois que o capítulo citava, e criava impressão falsa: "universal approximators" está no título do artigo de 1989 acima, do mesmo Hornik. O que é rótulo posterior é a promoção a teorema com nome próprio, e o capítulo passou a dizer isso |
| ✓ᵐ | Rumelhart, Hinton & Williams (1986) — doi:10.1038/323533a0, conferido no capítulo III.1 |
| ⏳ | Que a prática anterior era camada única com a regra do perceptron, ou pesos escondidos postos à mão |
| ⏳ | A leitura de Hornik de que a fonte do poder de aproximação é a estrutura em camadas, e não a ativação. A frase que costuma ser citada para isso vem do resumo de 1989, e não consegui abrir o texto para conferi-la; por isso ela não aparece entre aspas no capítulo |
| 📖 | Que 1986 entrega o procedimento, não a arquitetura — e que a licença teórica chegou depois da engenharia |
| 📖 | "Existência não é treinabilidade" como a ideia exportável, e os vinte anos do capítulo III.3 como o preço dela |
Duas retas: o que a camada escondida faz com o espaço
Volte ao laboratório do capítulo III.1 e olhe as retas que você conseguiu traçar. O OU funciona. O NÃO-E funciona. O XOR, não.
Agora repare: o XOR é exatamente (x₁ OU x₂) E (x₁ NÃO-E x₂) — "pelo menos um, mas não os dois". Duas fronteiras que você já sabe traçar, combinadas por uma terceira que você também já sabe traçar.
É isso que a camada escondida faz. Com o mesmo neurônio de limiar do capítulo III.1:
| Unidade | Pesos | Limiar | O que computa |
|---|---|---|---|
escondida h₁ |
w₁ = 1, w₂ = 1 |
θ = 1 |
OU |
escondida h₂ |
w₁ = -1, w₂ = -1 |
θ = -1 |
NÃO-E |
saída y |
w₁ = 1, w₂ = 1 |
θ = 2 |
E |
Confira nas quatro linhas: (0,0) → h=(0,1) → soma 1, não dispara. (0,1) → h=(1,1) → soma 2, dispara. (1,0) → idem, dispara. (1,1) → h=(1,0) → soma 1, não dispara. 4 de 4. O que era impossível em um plano ficou trivial em dois passos, porque a camada escondida reescreveu as entradas — h₁ e h₂ são coordenadas novas, e nelas o problema virou linearmente separável.
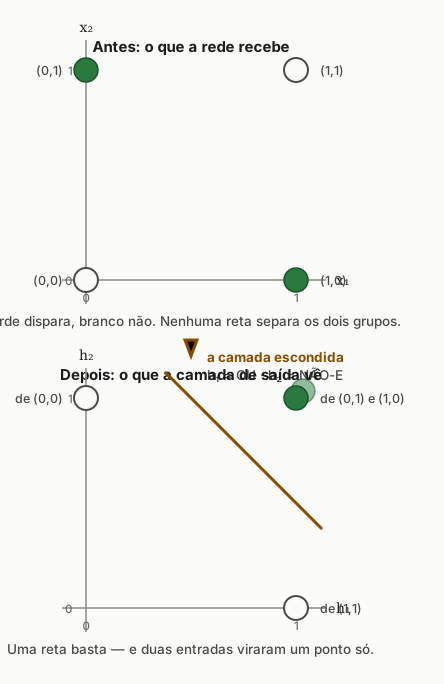
A figura é a frase acima, desenhada. Em cima, o problema que o capítulo III.1 provou impossível: quatro pontos, e nenhuma reta que separe os verdes dos brancos. Embaixo, os mesmos quatro casos depois de passarem pelas duas unidades escondidas, cada ponto rotulado pela entrada de onde veio. Agora uma reta basta.
Repare no rótulo do ponto verde de baixo, porque ele é o mecanismo. Os dois casos que devem disparar,
A tabela acima traz os pesos prontos, escolhidos à mão para você conferir a aritmética. A pergunta que ela deixa em aberto é outra: a rede consegue achar esses pesos sozinha?
redes-neurais-l1É o mesmo XOR em que o perceptron do capítulo III.1 oscilava sem fim. Aqui a rede é 2 → 2 → 1, com tanh na camada escondida, e ninguém escolheu peso nenhum: ela parte de valores aleatórios e desce o gradiente.
As duas retas são as fronteiras que as duas unidades escondidas estão aprendendo, e são o conteúdo da animação, não enfeite. Repare que a solução nunca vira uma fronteira curva: são duas retas, e quem as combina é a camada de saída — exatamente o (OU) E (NÃO-E) da tabela, encontrado sozinho.
Ponto com contorno é ponto que a rede ainda erra. Assista até a contagem fechar, na época 142.
Depois use os dois outros botões, nesta ordem.
"E sem a camada escondida?" deixa tudo igual e tira só a camada do meio. Mesma descida, mesma perda, mesmo tempo, e ela empaca em 24 de 48, que é o acaso. O que resolveu o XOR não foi o gradiente: foi a camada.
"E se a inicialização for infeliz?" mantém a camada e muda apenas de onde os pesos partem. A rede empaca em 24 de 48 com a perda parada em 0,348, e não sai mais dali. Não há erro nenhum: o método está correto, a implementação está correta, e a descida caiu num mínimo local. Varrendo 60 inicializações sobre este mesmo conjunto, 44 resolvem e 16 não.
Esse botão existe porque o problema apareceu de verdade ao construir esta animação — a primeira semente escolhida era uma das 16. É o modo de falha "inicialização ruim" do objetivo O4, e vê-lo aqui torna o resto do capítulo menos abstrato.
A arquitetura. Um perceptron multicamadas (multilayer perceptron, MLP) é isso, generalizado: uma camada de entrada (os atributos), uma ou mais camadas escondidas e uma camada de saída. Cada camada faz duas coisas, sempre nesta ordem: uma transformação linear (Wx + b) e uma não-linearidade aplicada elemento a elemento. A rede inteira é a composição dessas duas peças, repetida.
Contar os parâmetros. Uma camada que recebe
Numa rede 3 → 4 → 2, portanto: a primeira camada tem
Tire a não-linearidade e a profundidade some junto. Duas camadas lineares empilhadas, sem ativação no meio, são uma camada linear: o produto de duas matrizes é uma matriz. Você paga por profundidade e recebe uma regressão.
O caso extremo dessa família já é seu conhecido: uma camada, uma unidade, ativação sigmoide, e você tem a regressão logística do capítulo II.3. Um neurônio só.
redes-neurais-e5escolha umaO que a camada escondida faz para tornar o XOR resolvível?
redes-neurais-e1escolha umaUma rede tem duas camadas densas empilhadas, sem nenhuma função de ativação entre elas. O que essa rede consegue computar?
redes-neurais-e6escolha umaSegundo o capítulo, qual modelo já conhecido é o caso extremo de um MLP?
Achar os pesos: a culpa atravessa a camada
Agora o problema de 1969. Os pesos que fizeram o XOR fechar foram postos à mão, um a um. Como descobri-los a partir de dados?
Primeiro, o degrau tem de sair. A função-degrau do neurônio de McCulloch–Pitts é plana em toda parte e salta num ponto: sua derivada é zero onde existe e não existe onde importa. Sem derivada não há gradiente, e sem gradiente não há direção para onde mover o peso. Por isso as ativações usadas em rede treinável são contínuas: sigmoide, tangente hiperbólica, ReLU. Sem elas, a otimização do capítulo II.4 não tem o que ler.
O passo para frente. A entrada atravessa a rede camada a camada, e cada camada guarda o que calculou. No fim sai uma previsão, e a função de perda transforma previsão e rótulo num único número: o erro.
O passo para trás. O erro da saída depende dos pesos da última camada, o que é fácil de derivar. Mas ele também depende dos pesos da camada anterior, através da última camada. É a regra da cadeia: a influência de um peso lá atrás sobre o erro lá na frente é o produto das influências ao longo do caminho.
Fazer isso ingenuamente seria absurdo: recalcular o caminho inteiro para cada peso, com milhões de pesos, é trabalho repetido em escala industrial. O que torna o backpropagation viável é o reaproveitamento. Calcula-se o erro na saída, propaga-se para trás uma vez, e a quantidade que chega a cada camada é reusada por todos os pesos daquela camada. O custo do passo para trás fica da mesma ordem do passo para frente, e é aí que está a descoberta prática.
Backpropagation não é um algoritmo de otimização. Ele calcula o gradiente. Quem move os pesos é o gradiente descendente do capítulo II.4: a mesma otimização, os mesmos passos, a mesma regularização, só que numa superfície muito maior e cheia de vales.
Um passo inteiro, com números
Tudo acima é verdade e nenhum peso se mexeu ainda. Aqui um passo inteiro, com a menor rede que ainda precisa da regra da cadeia: duas entradas, duas unidades escondidas, uma saída, sigmoide nas duas camadas. Com uma unidade só não haveria o que retropropagar.
Os pesos iniciais são postos à mão, como no capítulo III.1. A diferença é que agora eles vão mudar sozinhos.
| para | peso de
|
peso de
|
viés |
|---|---|---|---|
|
|
0,5 | −0,4 | 0,1 |
|
|
0,3 | 0,8 | −0,2 |
| saída |
|
|
|
Um caso do XOR:
O passo para frente.
O passo para trás. A derivada da sigmoide se escreve na própria ativação,
Esse
E o mesmo número atravessa para a camada de baixo, cada unidade pesada pelo caminho que a liga à saída:
Repare no sinal trocado de
A atualização, com
| peso | antes | gradiente | depois |
|---|---|---|---|
|
|
0,5 | −0,0302 | 0,5151 |
|
|
−0,4 | 0 | −0,4 |
|
|
0,1 | −0,0302 | 0,1151 |
|
|
0,3 | +0,0384 | 0,2808 |
|
|
0,8 | 0 | 0,8 |
|
|
−0,2 | +0,0384 | −0,2192 |
|
|
0,6 | −0,1420 | 0,6710 |
|
|
−0,7 | −0,1155 | −0,6423 |
|
|
0,2 | −0,2200 | 0,3100 |
Perda de 0,1982 para 0,1578, previsão de 0,5548 para 0,6027. Um passo, e a rede andou na direção certa.
Há uma lição escondida nas duas linhas cujo gradiente deu zero. Os pesos
E quando há mais de duas classes
O exemplo acima tinha uma saída só. Com mais de duas classes, a última camada produz um número por classe, e o softmax os converte em probabilidades que somam 1: exponencia cada um e divide pela soma. A perda passa a ser a entropia cruzada, que pune com força a confiança errada — prever 0,99 na classe errada custa muito mais do que prever 0,5. As duas andam juntas por um motivo: combinadas, o gradiente na saída se reduz a previsão − rótulo, que é simples de derivar e estável de calcular.
redes-neurais-e7escolha umaPor que a função-degrau precisou sair para que a rede pudesse ser treinada?
redes-neurais-e13responda com um númeroNa rede do exemplo acima, a saída deu
Calcule
redes-neurais-e14escolha umaNa tabela de atualização, os pesos
Um passo não é treinar: o planalto
A rede andou na direção certa naquele passo, e um passo ainda não é treino. Aqui está ela sobre os quatro pontos do XOR, em lote cheio:
| época | EQM | 00 |
01 |
10 |
11 |
acertos |
|---|---|---|---|---|---|---|
| 0 | 0,2520 | 0,55 | 0,50 | 0,55 | 0,51 | 2/4 |
| 100 | 0,2507 | 0,52 | 0,48 | 0,52 | 0,48 | 2/4 |
| 500 | 0,2502 | 0,51 | 0,48 | 0,52 | 0,49 | 2/4 |
| 1 000 | 0,2500 | 0,51 | 0,49 | 0,51 | 0,49 | 2/4 |
| 2 000 | 0,2499 | 0,51 | 0,49 | 0,51 | 0,49 | 2/4 |
| 4 000 | 0,1865 | 0,42 | 0,39 | 0,75 | 0,36 | 3/4 |
| 8 000 | 0,0017 | 0,04 | 0,95 | 0,96 | 0,04 | 4/4 |
| 15 000 | 0,0005 | 0,02 | 0,97 | 0,98 | 0,02 | 4/4 |
O que essa tabela ensina não é que a rede aprende, e sim o planalto. Por duas mil épocas o erro fica parado em 0,25 e as quatro saídas ficam em torno de 0,5, o que é a rede respondendo "sei lá" para tudo. Ela parece morta e não está. A quebra vem entre 2 000 e 4 000, e depois a perda cai três ordens de grandeza em poucos milhares de épocas.
Quem desiste na época 1 000 conclui que o método não funciona, e conclui isso com uma tabela na mão. Distinguir empacar por planalto de empacar por mínimo local exige rodar mais, e é a diferença entre os dois que a seção de diagnóstico deste capítulo trata.
redes-neurais-e15escolha umaVocê treina a rede do exemplo no XOR e vê a perda parada em 0,2500 da época 100 à 2 000, com as quatro saídas em torno de 0,5. Qual leitura o próprio capítulo sustenta?
redes-neurais-l3Esta é a rede da conta à mão, e você segura o botão. Aperte "Um passo" uma vez e compare com a tabela que acabou de ler: o caso é
Repare nas duas linhas com gradiente zero, destacadas. São
Depois solte: "Uma época" percorre os quatro casos, "100 épocas" acelera. A tabela da seção anterior usa lote cheio — um ajuste por época, com os quatro casos somados. Aqui o ajuste é por caso, quatro por época, e por isso o XOR fecha muito antes: 583 épocas com a partida do capítulo e
Escreva a previsão antes de mexer
Troque "Partida dos pesos" para "tudo zero". Zero parece a partida mais neutra que existe, e a previsão quase unânime é "vai demorar mais".
Está errada, e o erro não é de grau. A rede nunca fecha o XOR. Ela empaca em 3 de 4 — exatamente onde o perceptron do capítulo III.1 empacava, com a diferença de que agora há uma camada escondida inteira sem servir para nada.
A razão está no placar, e ele diz em voz alta:
e continuam idênticas. Com todos os pesos iguais, as duas unidades calculam a mesma coisa, recebem o mesmo delta e mudam do mesmo jeito, para sempre. Nada no método quebra o empate. Duas unidades escondidas viram uma. É por isso que inicialização é assimetria, e não ruído decorativo. Sortear os pesos não serve para "começar em algum lugar": serve para que as unidades comecem diferentes umas das outras. Guarde este mecanismo, porque ele é o mesmo que o capítulo III.3 retoma ao explicar por que a escala da inicialização decide se o gradiente some ou explode.
redes-neurais-e19escolha umaNo laboratório acima, com a partida "tudo zero", a rede empaca em 3 de 4 e o placar avisa que
Contar os parâmetros, e o bug que não grita
A regra de contagem já apareceu: e × s + s, com um viés por unidade de destino. Vale praticá-la, porque errá-la não costuma derrubar o programa: a rede apenas treina mal, em silêncio.
redes-neurais-e2responda com um númeroUm MLP denso tem 4 entradas, uma camada escondida de 5 unidades e 3 saídas. Todas as camadas têm viés.
Quantos parâmetros treináveis a rede tem no total?
redes-neurais-e9responda com um númeroUma rede densa tem 10 entradas, duas camadas escondidas de 8 unidades cada, e 1 saída. Todas as camadas têm viés.
Quantos parâmetros treináveis ela tem?
redes-neurais-e10escolha umaAo implementar a rede em NumPy, a soma do viés "funciona" por broadcasting mesmo com o vetor de tamanho errado, e a rede treina mal sem lançar exceção. O que esse caso ilustra?
redes-neurais-e8escolha todas que valemQuais afirmações sobre backpropagation são corretas? (marque todas que valem)
Mão na massa: o mesmo método em 20 640 bairros
Tudo até aqui aconteceu em quatro pontos. Agora o mesmo método, sem nada de novo, sobre 20 640 bairros da Califórnia: o preço mediano do imóvel de cada um, a partir de oito atributos do censo de 1990.
"Bairro" aqui tem nome técnico, e vale saber qual, porque a tradução fácil erra. Cada linha é um block group, que fica um degrau abaixo do census tract. Quem traduz por "setor censitário" e vai procurar acaba no census tract, que é cerca de três vezes maior, e sai com a intuição errada sobre o que uma linha representa.
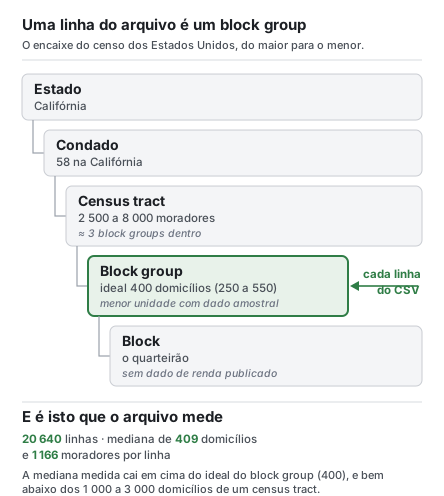
A definição vem do próprio Census Bureau, e o scikit-learn a repete na documentação do conjunto: o block group é a menor unidade para a qual o censo publica dado amostral. Abaixo dele há o block, o quarteirão, e para o quarteirão não se publica renda.
A etapa está em ml-zero/etapa-19/mlp.py, e os dados estão congelados no repositório, com ficha e sha256. Nada é baixado quando você roda.
python ml-zero/etapa-19/mlp.py
A ponte com o que você acabou de calcular cabe numa linha. A rede tem alguns milhares de pesos em vez de nove, e eles moram exatamente onde a conta manda:
mlp.coefs_[0].shape # (8, 64) — a matriz entradas × ocultas
É a mesma matriz
intercepts_ é o viés por unidade de destino. Uma rede 8 → 64 → 1 tem
Abrir no Colab, sem instalar nada
Se você prefere clicar a digitar, o mesmo caminho está num notebook:
| O quê | Como usar |
|---|---|
| Notebook no Colab | abrir direto no Google Colab — não precisa instalar nada nem ter conta em lugar nenhum |
| Scripts | mlp.py · rede.py · dados_kaggle.py |
O notebook começa antes do que esta seção começa, e é por isso que vale abri-lo. Ele baixa o conjunto do Kaggle, com o mesmo trecho que aparece na página de lá:
import kagglehub
path = kagglehub.dataset_download("camnugent/california-housing-prices")
E o que vem por esse caminho não é o arquivo de nove colunas que a tabela acima usa. São dez colunas do censo de 1990, com uma coluna de texto, ocean_proximity, e 207 linhas sem total_bedrooms. O arquivo limpo é o resultado de um preparo que alguém fez, e que ninguém vê; o notebook faz você refazê-lo:
Três dos oito atributos são razões, e é aí que está o raciocínio. total_rooms sozinho diz o tamanho do setor, não o tamanho das casas: um setor com 5 000 domicílios tem mais cômodos que um com 200 sem que ninguém more melhor. Dividir por households é o que torna a coluna comparável entre os dois.
Depois o notebook confere a sua derivação contra o arquivo congelado, coluna a coluna. É o mesmo instrumento das linhas de base, um passo antes: saber que errou antes de tirar conclusão sobre modelo.
O achado que só aparece comparando as duas cópias
As 207 linhas que o arquivo do Kaggle tem em branco não estão em branco no arquivo que o
scikit-learndistribui. E os valores de lá são inteiros: 217, 279, 1 394, com 186 valores distintos entre os 207.Isso descarta preenchimento: imputar pela média ou pela mediana daria um número quebrado, e o mesmo número repetido 207 vezes. O que há ali é dado que uma das duas cópias perdeu pelo caminho.
Duas versões do mesmo conjunto discordam sobre 207 linhas, as duas se chamam "California Housing", e nenhuma das duas avisa. É por isso que a ficha do dado, com origem e
sha256, não é burocracia: sem ela, "usei o California Housing" não identifica o que você usou.O repositório guarda a cópia crua congelada, e ela é byte a byte a que o Kaggle entrega — conferido, e não suposto. Se o download falhar por rede, cota ou revisão nova do conjunto, o notebook segue pela cópia local e diz que fez isso.
As duas linhas de base são um instrumento, não concorrentes
Antes do MLP, o programa treina dois modelos que ninguém espera que ganhem: prever sempre a mediana, e uma regressão linear. Elas existem por outro motivo.
| modelo | erro médio absoluto no teste |
|---|---|
| mediana | 0,8982 |
| regressão linear | 0,5271 |
MLP 8 → 64 → 1, tanh |
0,3878 |
O alvo está em centenas de milhares de dólares, então a rede erra em média US$ 38,8 mil contra US$ 52,7 mil da regressão linear.
As linhas de base são o checksum do protocolo. Se o seu número da regressão linear não for 0,5271, você não achou um modelo melhor: você leu outro arquivo, usou outro recorte ou trocou a métrica. Descobrir isso antes de comparar arquiteturas elimina toda uma classe de discussão que não é sobre modelo nenhum.
É por isso também que o recorte treino/validação/teste está gravado num arquivo em vez de sorteado na hora. Sorteio parece inofensivo, e não é: o embaralhamento pode mudar entre versões da biblioteca, e duas turmas em semestres diferentes deixariam de ser comparáveis.
A armadilha que não avisa
Rode de novo, agora sem padronizar os atributos:
python ml-zero/etapa-19/mlp.py --cru
| padronizado | cru | |
|---|---|---|
| erro do MLP | 0,3878 | 0,5193 |
| amplitude entre 5 sementes | 0,0060 | 0,0258 |
| épocas até parar | 238 a 336 | 52 a 76 |
Nada quebra. Nenhuma exceção, nenhum aviso. O erro sobe 34%, e o resultado fica praticamente empatado com a regressão linear — o que produz a conclusão coerente e falsa "testei, a rede não ganha neste problema". É a mesma família do erro de dimensão que o exercício sobre viés discute: ausência de exceção não é evidência de correção.
O sintoma que denuncia está na terceira linha. A rede crua não treinou mais rápido: ela desistiu antes, em 52 a 76 épocas contra 238 a 336. O critério de parada viu a perda deixar de melhorar num terreno em que o mesmo passo é grande demais numa direção e minúsculo noutra. E a instabilidade entre sementes quadruplica, o que significa que dois colegas com sementes diferentes vão discutir uma diferença que é só ruído.
A causa está na ficha dos dados: Population tem desvio padrão 1 132 e AveBedrms tem 0,474. Uma razão de 2 390 vezes.
E a mesma rede, escrita à mão
Esta etapa usa uma rede pronta. O objetivo O3 deste capítulo promete outra coisa: implementar a rede densa em NumPy, do passo para frente ao update. Isso está em ml-zero/etapa-19/rede.py, ao lado, e roda em segundos:
python ml-zero/etapa-19/rede.py
Ele começa refazendo o passo que você calculou à mão, com os mesmos nove pesos e o mesmo caso, e imprime os mesmos
A parte que vale copiar para os seus projetos é a conferência de gradiente. Escrever retropropagação é fácil; escrever retropropagação certa é outra coisa, e um sinal trocado não lança exceção nenhuma. A rede treina, a perda desce um pouco, e você culpa a taxa de aprendizado. O arquivo compara o gradiente calculado pela regra da cadeia com a diferença finita da perda:
Se os dois discordarem, há defeito na conta, e você descobre em um segundo em vez de em três dias de treino. É o mesmo raciocínio do exercício sobre viés, aplicado a você: ausência de exceção não é evidência de correção — então arranje uma evidência.
E há uma medição para levar junto, porque ela custou uma. A primeira versão daquele arquivo aplicava a ativação em todas as camadas, inclusive na saída. Nada quebrou. O erro no California Housing deu 1,1610, pior do que prever sempre a mediana, e o motivo é simples depois de visto: tanh não passa de 1, e o alvo vai até 5. A rede estava impedida de acertar por construção. Saída de regressão não leva não-linearidade, e é isso que a biblioteca faz por padrão quando você não olha.
redes-neurais-e16responda com um númeroRode a etapa com uma camada escondida de 32 unidades, e não 64:
python ml-zero/etapa-19/mlp.py --ocultas 32
Quantos parâmetros treináveis o programa imprime?
Pela regra
e × s + s, camada a camada: entrada para escondida,; escondida para saída, . Total 321. São os oito atributos do censo, e não sete nem nove — o alvo MedHouseValnão entra como entrada.Pelo programa, a última linha da saída imprime o mesmo 321. Se os dois números não baterem, não discuta o modelo: conte de novo, ou confira quantas colunas o
Xrealmente tem.Repare no que não mudou: as duas linhas de base continuam em 0,8982 e 0,5271. Elas não dependem da arquitetura, e é exatamente por isso que servem de checksum do protocolo.
redes-neurais-e17escolha umaCom --cru, o MLP para em 52 a 76 épocas; padronizado, leva de 238 a 336. O erro no teste sobe de 0,3878 para 0,5193, e nenhuma exceção é lançada. Qual é o diagnóstico?
redes-neurais-e18responda com suas palavrasRelate o seu experimento. Escolha uma configuração diferente da do capítulo, com outra largura ou com duas camadas escondidas, e rode:
python ml-zero/etapa-19/mlp.py --ocultas <a sua escolha>
Antes de rodar, escreva a sua previsão: o erro vai ficar acima ou abaixo de 0,3878? Depois relate, em um parágrafo: os dois números das linhas de base que você obteve, a configuração que usou, o número de parâmetros, a mediana e a amplitude entre as cinco sementes — e diga se a sua configuração é melhor que a do capítulo, justificando com a amplitude.
Quantas camadas e quantas unidades — a decisão é empírica
O teorema diz que uma camada escondida basta. Não diz quantas unidades — e "unidades suficientes" pode significar um número absurdo. Redes mais profundas costumam resolver com menos unidades por camada o que uma camada rasa só resolveria com muitas. Isso é observação empírica, não consequência do teorema.
Comece pequeno, aumente até a rede conseguir overfitar um subconjunto pequeno dos dados — se ela não consegue decorar 50 exemplos, o problema é capacidade ou bug, não regularização. Depois regularize para trazer a generalização de volta, com as ferramentas do capítulo II.4. O número de camadas e de unidades é hiperparâmetro, e hiperparâmetro se escolhe com dados de validação.
redes-neurais-l2Este é o TensorFlow Playground, servido daqui mesmo — ele funciona com a sua rede fora do ar, e não manda nada para lugar nenhum. É código de terceiro sob Apache 2.0, e não um produto oficial do Google; a procedência está em publicar/tema/playground/LEIA-ME.md.
Ele tem oito controles, e é aí que mora o perigo. Mexer em três coisas ao mesmo tempo, ver a perda cair e não saber qual delas causou é o oposto de aprender. Então a regra deste laboratório é uma só: uma manopla por pergunta, e você escreve a previsão antes de mexer.
A interface está em inglês. A tradução dos rótulos:
| Na tela | Em português |
|---|---|
| Learning rate | taxa de aprendizado |
| Activation | função de ativação |
| Regularization / rate | regularização e a força dela |
| Features | atributos de entrada |
| Hidden layers | camadas escondidas |
| Training / Test loss | perda de treino e de teste |
| Noise | ruído nos dados |
| Ratio of training to test data | proporção treino/teste |
As cinco perguntas
- Dados em círculo, zero camadas escondidas, só
x₁ex₂. Preveja a perda antes de rodar. Depois acrescentex₁²ex₂²como entrada. Pergunta: por que a camada escondida dispensa esse gesto manual? - Espiral: 1 camada de 8 unidades contra 2 camadas de 4. A contagem de parâmetros é parecida. Preveja qual treina melhor. Erra-se aqui com frequência.
- Espiral, 4 camadas, ativação
Linearem todas. Desenhe num papel a fronteira que você espera, e só então rode. É o exercícioe1deste capítulo, em movimento. - A mesma configuração, reinicializada cinco vezes. Quantas resolvem? Compare com as 44 de 60 que a animação do XOR mediu, logo acima.
- Troque
tanhporReLU. Pergunta final, e é a que separa quem leu o teorema de Hornik de quem decorou o nome dele: mudou o que a rede pode representar, ou só o quanto ela consegue treinar?
O teorema não decide por você
Aqui a tese do capítulo cobra o preço: existência não é treinabilidade. O teorema garante que existe uma configuração de pesos que resolve seu problema. Ele não garante que o seu treino vá encontrá-la — a inicialização pode ser ruim, o gradiente pode sumir antes de chegar às primeiras camadas, os dados podem ser insuficientes para distinguir aquela solução de mil outras. É por isso que empilhar mais camadas não funcionou por quase vinte anos depois de 1986, apesar de o teorema já estar publicado desde 1989. O capítulo III.3 conta o que foi preciso para destravar.
redes-neurais-e3responda com suas palavrasUm colega justifica a escolha da arquitetura assim: "pelo teorema da aproximação universal, uma camada escondida basta — então se o modelo não está aprendendo, é porque faltam unidades."
Explique por que o teorema não sustenta essa conclusão, e liste o que mais pode estar impedindo o treino.
redes-neurais-e11escolha umaNa animação deste capítulo, a rede com camada escondida empaca em 24 de 48 quando a inicialização muda, e resolve com a inicialização padrão. O dado, a arquitetura e a taxa são os mesmos. Qual é o diagnóstico?
redes-neurais-e12escolha todas que valemUma rede não aprende. Quais verificações vêm antes de aumentar o número de unidades? (marque todas que valem)
Síntese — o que levar
- O XOR do capítulo III.1 está resolvido: uma camada escondida traça duas fronteiras (OU e NÃO-E) e a saída as combina (E). 4 de 4.
- A camada escondida não acrescenta retas: reescreve as entradas em coordenadas onde o problema vira linearmente separável.
- A não-linearidade é o que torna a camada uma camada. Sem ela, camadas empilhadas colapsam numa só transformação linear.
- Um MLP é composição de
linear → não-linearidade, repetida. Uma unidade, sigmoide, e você tem a regressão logística do capítulo II.3. - O degrau não serve como ativação treinável: sem derivada não há gradiente.
- Backpropagation é a regra da cadeia com reaproveitamento. Propaga-se o erro para trás uma vez, e cada camada reusa o que chegou — é o reaproveitamento que torna o custo viável, não a regra da cadeia em si.
- Backpropagation calcula o gradiente; quem move os pesos é a otimização do capítulo II.4.
- Softmax + entropia cruzada para multiclasse: o gradiente na saída vira
previsão − rótulo. - 1986 não entregou a arquitetura — entregou o procedimento. A licença teórica (1989, 1991) chegou depois da engenharia.
- A ideia exportável: existência não é treinabilidade. O teorema é não construtivo — garante que a rede certa está no espaço de hipóteses, sem dizer quantas unidades, como achá-la, ou se o gradiente chega lá.
- Camadas e unidades são hiperparâmetros: escolhem-se sob validação, não por teorema.
- Linha de base é instrumento, não concorrente: mediana e regressão linear são o checksum do protocolo. Número diferente do colega significa recorte ou métrica diferente, antes de significar modelo melhor.
- Escala de atributo é modo de falha silencioso. Sem padronizar, o mesmo MLP erra 34% mais, para cedo e não avisa — e o resultado, empatado com a regressão linear, sustenta a conclusão falsa de que a rede não serve.
- Uma semente é amostra de tamanho 1: reporte mediana e amplitude, e compare diferenças contra a amplitude antes de declarar vencedor.
redes-neurais-e4responda com suas palavrasDesafio de fechamento. Explique backpropagation a alguém que conhece a regra da cadeia mas nunca viu uma rede. Diga o que é o passo para frente, o que é o passo para trás e, na parte que decide, onde exatamente está o reaproveitamento que torna o custo viável.
Verificação
- Escreva os pesos e limiares de um MLP que computa o XOR e confira as quatro linhas da tabela-verdade. Depois explique, em uma frase, o que a camada escondida fez com o espaço de entrada.
- "Uma camada escondida basta para aproximar qualquer função contínua." Diga o que essa frase garante, o que ela não garante, e por que a diferença entre as duas coisas custou quase vinte anos à área.
Estas duas não são corrigidas, e a omissão é deliberada: a primeira vale mais como construção no papel, conferida por você linha a linha, do que como texto — e a segunda rende mais numa discussão.
Errata
O que este capítulo já afirmou e teve de corrigir. Fica no fim, e não no meio do texto, porque é registro de manutenção e não conteúdo de aula — mas fica, porque um livro que corrige em silêncio pede confiança em vez de merecê-la.
| Quando | O que estava escrito | O que está agora |
|---|---|---|
| 2026-08-28 | A seção prática dizia "20 640 setores censitários da Califórnia" | A unidade é o block group, que fica um degrau abaixo do census tract. "Setor censitário" leva quem procura ao census tract, cerca de três vezes maior, e com ele a intuição errada sobre o que uma linha representa. Corrigido no capítulo, na ficha do dado e na etapa, com a figura do encaixe e as fontes do Census Bureau |